source-to-skill
Jeden příkaz udělá z přednášky, podcastu, odborné studie, knihy, článku nebo repozitáře skill, který si tvůj coding agent načte, až ho bude potřebovat. A každá odpověď odkazuje zpátky na zdroj — u nahrávky s přesností na půl minuty.
source-to-skill namíří coding agenta na něco, co stojí za to znát, a vrátí mu skill, který si načte, až ho bude potřebovat. Dvouhodinová přednáška, RSS feed podcastu, paper Attention Is All You Need, EPUB, blogpost, repozitář Flasku — na každý stačí jeden příkaz. Výsledkem je složka strukturovaného Markdownu, do které se agent podívá, až na ni přijde řeč. Ne přepis nasypaný do kontextového okna.
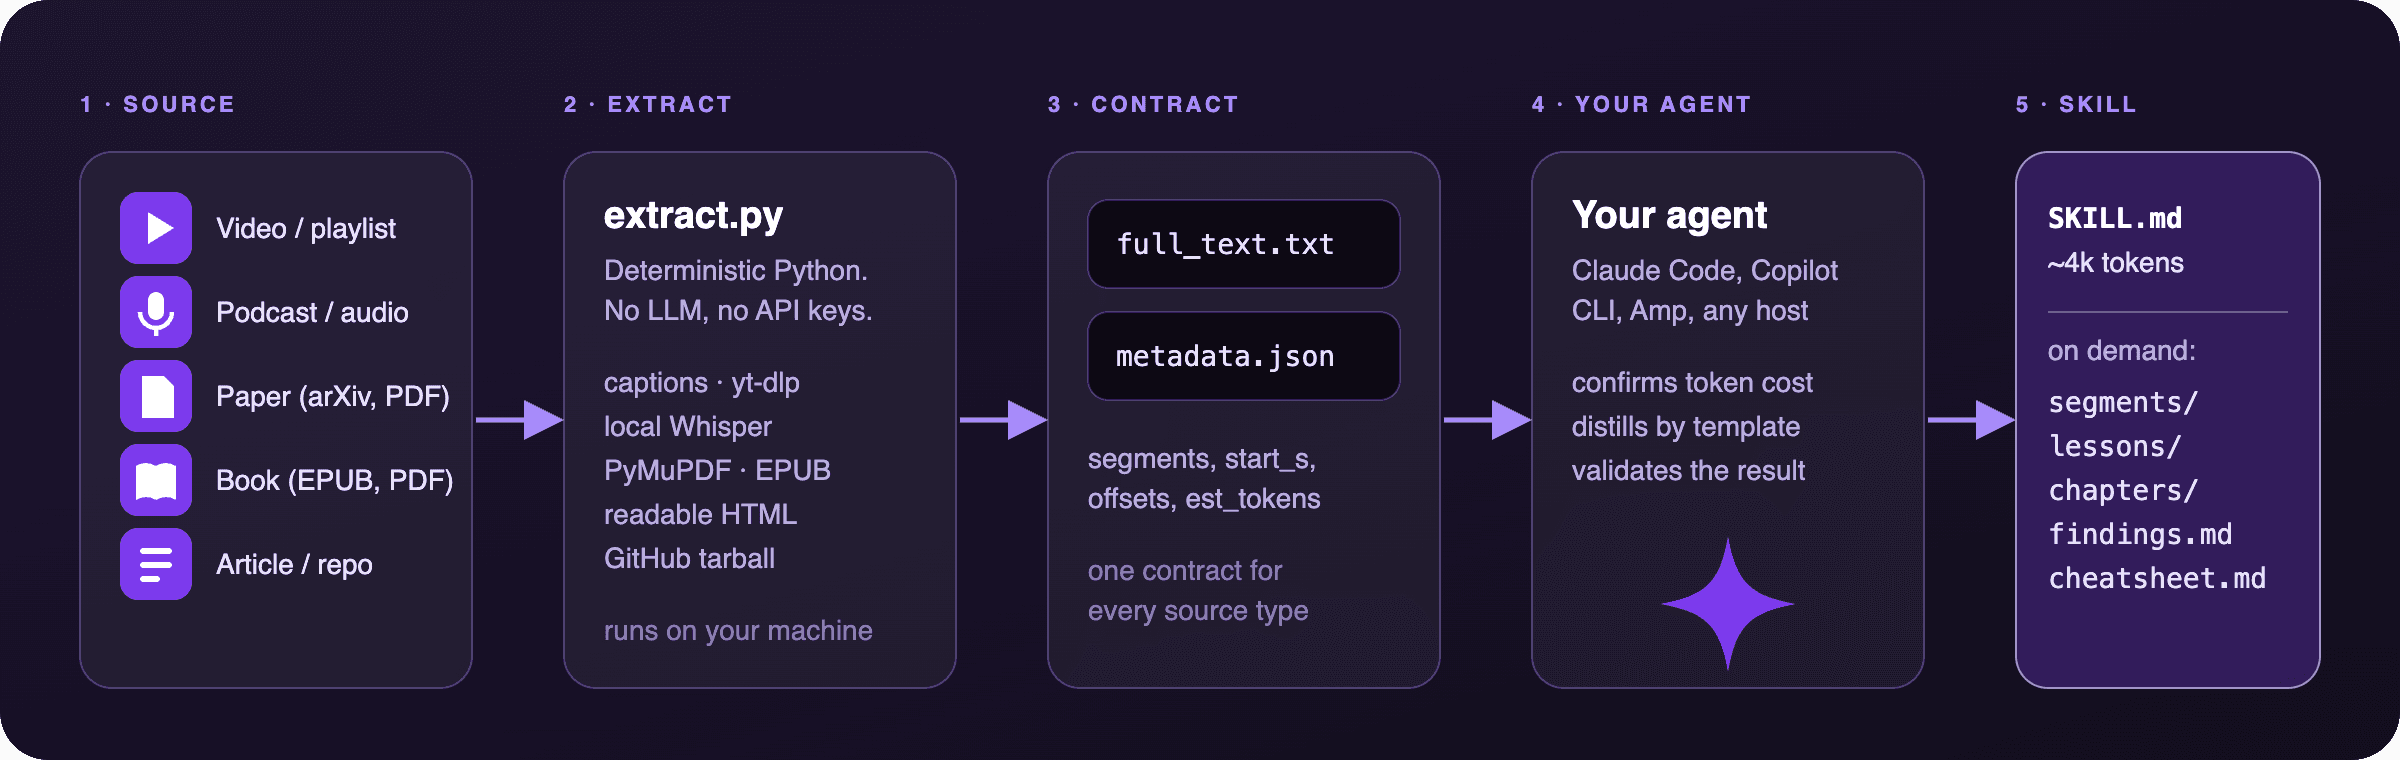
Celý návrh stojí na jednom rozdělení. Deterministický extraktor v Pythonu převede každý typ zdroje do stejného formátu — čistý text a metadata — a destilaci pak dělá agent podle instrukcí, které si skill nese s sebou. Nástroj sám nevolá žádné API modelu: nahrávku bez titulků přepíše Whisper přímo na tvém počítači a destilaci odvede model, se kterým už mluvíš. Odpovědi z nahrávky odkazují přes &t= na vteřinu, papery drží metody, zjištění a limity odděleně, z playlistu nebo podcastu vznikne kurz a z několika zdrojů jeden skill, který si vede seznam, v čem se neshodnou.
problém
Coding agent je skvělý v tom, co už umí, a bezradný před dvouhodinovou přednáškou, kterou jsi viděl minulý týden. Nabízí se vložit mu přepis — jenže to je špatně hned dvakrát. Zaprvé je velký: přepis o pouhých 4 962 slovech má zhruba 6 600 tokenů textu, který z okna vytlačí všechno ostatní. Zadruhé je to vyprávění, tedy formát, který má k odpovědi, jakou chceš, nejdál.
Agent potřebuje strukturu: rámce, rozhodovací pravidla, konkrétní čísla a cestu zpátky k originálu, když je potřeba odpověď ověřit. To je jiný výstup než shrnutí a přesně na tohle je formát Agent Skills — instrukce, které si agent načte, když je situace vyžaduje, a jinak si jich nevšímá.
půlka deterministická, půlka na úsudku
Extrakce a destilace jsou dva různé problémy a nástroj je odmítá míchat. extract.py pozná typ zdroje z URL nebo souboru, spustí odpovídající parser a do pracovní složky zapíše tři věci: full_text.txt, metadata.json a source.json — manifest, díky kterému jde skill později obnovit. Nahrávku bez titulků tady taky přepíše Whisper, lokálně, podle toho, který backend máš nainstalovaný. Tahle půlka je obyčejný Python — testovatelný, opakovatelný, a buď funguje, nebo řekne, proč ne.
Destilace je ta půlka, která vyžaduje úsudek, a proto zůstává agentovi. SKILL.md mu popíše, jak vypadá dobrý skill pro daný typ zdroje. Agent si přečte extrahovaný text, nejdřív si s tebou odsouhlasí cenu v tokenech, pak zapíše soubory a výsledek ověří přes validate_skill.py. Žádný další model někde na serveru v tom není — ten, který je potřeba, už sedí u stolu.
Díky tomu 320 testů pokrývá tu část, kterou pokrýt jde, a nepředstírá, že pokrývá i tu druhou. A všechny běží bez připojení k síti.
jeden formát, sedm parserů
co z toho vznikne
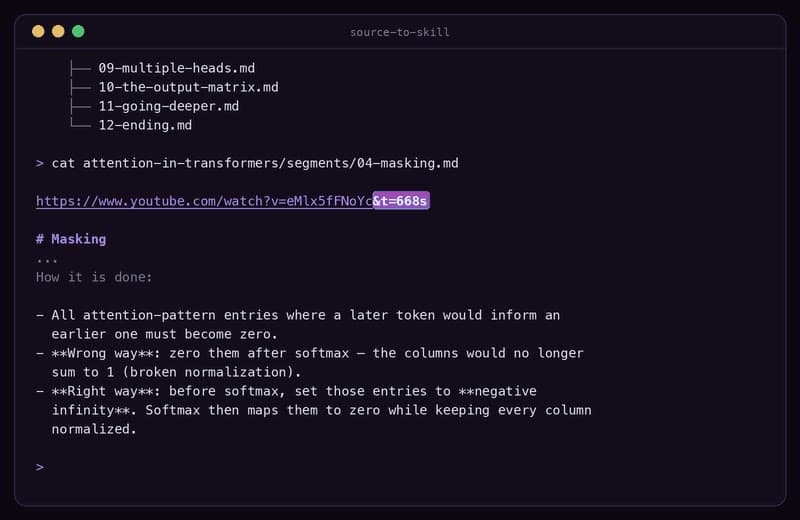
Z dvouhodinové přednášky o dvanácti kapitolách vznikne dvanáct souborů se segmenty. SKILL.md nese hlavní myšlenky a rejstřík segmentů a má strop kolem 4 000 tokenů — v galerii příkladů vychází mezi 1,1k a 2,0k. Je to jediná část, kterou agent standardně platí. Segment si přečte, až když otázka opravdu míří do jeho kapitoly, a cheatsheet.md obsahuje konkrétní kroky a rozhodovací pravidla bez jakéhokoli vyprávění.
Papery si drží svou přirozenou strukturu — methods.md, findings.md, limitations.md, glossary.md, citations.md. Když se totiž limity slijí do shrnutí, začne se paper citovat na něco, o čem sám výslovně napsal, že to neprokázal. Knihy si nechávají kapitoly. Z playlistu, kanálu nebo podcastu vznikne kurz: rejstřík lekcí, jeden soubor na video nebo epizodu a jeden cheatsheet pro celou sérii.
odpověď ukáže na vteřinu, ze které pochází
Každý segment začíná odkazem do zdroje na čas, kde segment začíná. Zeptáš se na masking a odpověď přijde s &t=668s — jedenáct minut a osm vteřin, přesně tam, kde o tom přednášející mluví.
Od verze 0.5 už dlouhá kapitola není jeden odkaz: přepis nese značku každých 30 vteřin, takže tvrzení odkáže s přesností na půl minutu, za zhruba 3 % tokenů navíc. Podcasty a audio soubory to mají stejně, s #t= tam, kde se v originále dá přetáčet.
Právě tohle dělá skill nejen pohodlným, ale i důvěryhodným. Destilace je tvrzení o tom, co zdroj říká, a tvrzení, které si nemůžeš ověřit jedním kliknutím, nakonec musíš brát na slovo. Papery a články dělají totéž s původní URL, skill z repozitáře odkazuje na soubor dokumentace, ze kterého vznikl.
jedenáct zdrojů, jeden příkaz
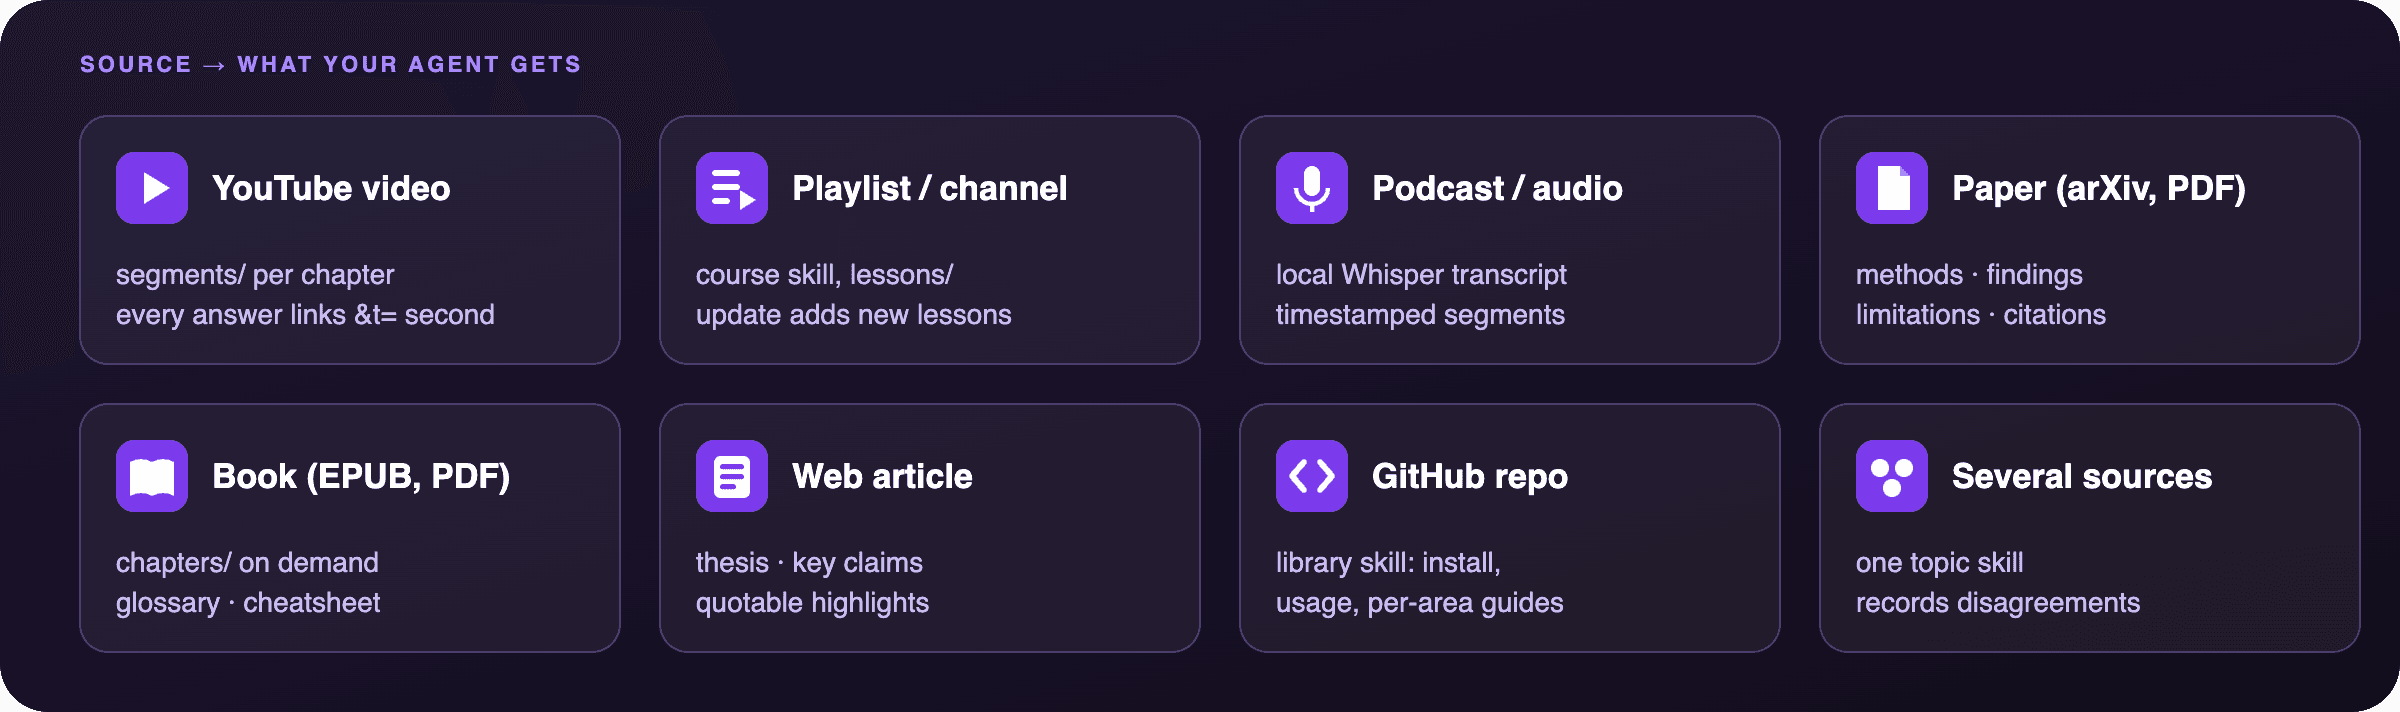
- YouTube video — titulky přes yt-dlp, přednostně ruční, automatické jako záloha, v jakémkoli jazyce; dělí se podle kapitol samotného videa. Když titulky nemá vůbec, přepíše ho lokální Whisper, pokud ho máš nainstalovaný.
- Playlist a kanál — z playlistu vznikne kurz, z kanálu jeho posledních 20 videí (
--limit N). Video bez přepisu se s varováním přeskočí, a když běh narazí na rate limit YouTube, řekne to, místo aby sváděl vinu na chybějící titulky. - Epizoda podcastu, celý podcast, jakákoli nahrávka — odkaz z Apple Podcasts, RSS feed (posledních pět epizod jako jeden kurz), přímé
.mp3, lokální záznam z callu nebo cokoli dalšího, co stáhne yt-dlp. Přepis dělá mlx-whisper nebo faster-whisper na tvém počítači. Spotify je chráněný DRM, takže ten ne. - Paper — PyMuPDF s rozpoznáním akademických sekcí; u URL z arXivu si název, autory a rok vezme z arXiv API a reference rozdělí po jedné.
- Kniha — EPUB zvládne samotná standardní knihovna, kód si drží odsazení a tabulky zůstanou tabulkami. U knihy v PDF se kapitoly berou z osnovy dokumentu.
- Webový článek — vytažení čitelného obsahu, rovněž jen standardní knihovnou: přednost má
<article>, navigace, patičky a skripty jdou pryč a autora najde v JSON-LD, i když ho stránka schovává. - GitHub repozitář — README a
docs/jediným stažením tarballu, bez klonování, v Markdownu, MDX i reStructuredTextu, seřazené tak, jak je řadí obsah samotné dokumentace.
víc zdrojů a kde se neshodnou
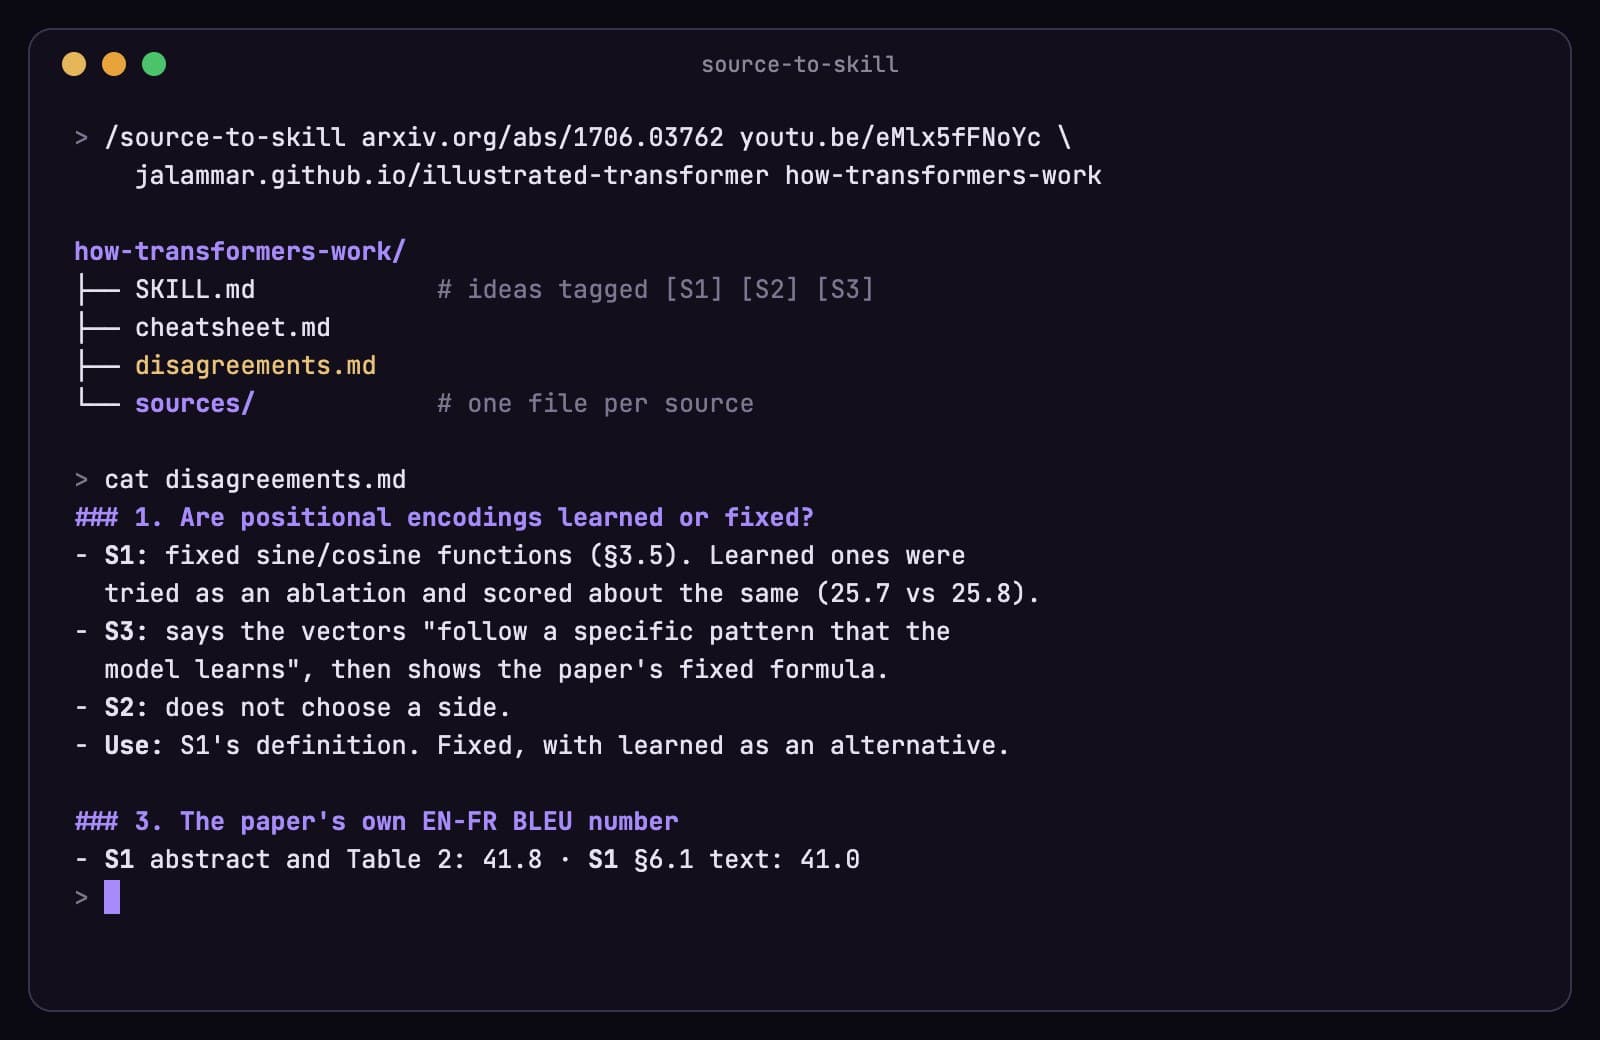
Když dáš víc zdrojů, dostaneš jeden tematický skill. Každá myšlenka nese zdroje, ze kterých pochází ([S1], [S2]), a disagreements.md zapisuje, kde si odporují nebo používají jiná čísla či definice — vedle sebe, nikdy zprůměrované do jednoho tvrzení. Průměrování je přesně to, co shrnutí dělá samo od sebe, a přesně tak vzniká sebevědomá špatná odpověď.
Příklad v galerii skládá dohromady Attention Is All You Need, video od 3Blue1Brown a Illustrated Transformer od Jaye Alammara. Shodnou se na vzorci a rozcházejí se ve věcech, na kterých záleží: jestli je poziční kódování naučené, nebo pevné, jak jsou ve vektoru rozložené sinus a kosinus — a paper si odporuje i sám se sebou, v abstraktu uvádí 41,8 BLEU a v textu 41,0.
Skill si taky pamatuje, odkud vzešel. /source-to-skill update znovu vytáhne playlist nebo kanál, porovná ho s uloženým source.json a vygeneruje jen nové lekce.
klíčová rozhodnutí
- Žádné API klíče, nikde. Přepis běží na tvém počítači a destilaci odvede agent, kterého už platíš. Kdo po lidech chce klíč, o většinu z nich přijde hned v prvním kroku.
- Standardní knihovna všude, kde stačí. EPUB, webové články a GitHub repozitáře nepotřebují nic doinstalovat.
yt-dlp,PyMuPDFa Whisper vyžadují jen zdroje, které je opravdu potřebují, a--checkti řekne, co chybí — i to, že máš yt-dlp tak starý, že ho YouTube brzy začne odmítat. - Tarball, ne klon. Na čtení dokumentace není potřeba historie repozitáře a jedno stažení je spolehlivější než klon, který u velkého repa na pomalé lince spadne.
- Nejdřív odsouhlasit cenu, pak utrácet. Extraktor ohlásí počet slov a odhad tokenů a agent se před destilací zeptá. Dvouhodinová přednáška není zadarmo a nástroj nepředstírá opak.
- Galerii vyrobil sám nástroj. Každý skill v
examples/— přednáška, kurz, paper, Pro Git, esej, Flask a téma ze tří zdrojů — vznikl z odkázaného zdroje a CI je všechny validuje. Výstup si tak přečteš dřív, než cokoli nainstaluješ. - Repo je svým vlastním prvním skillem.
skills/source-to-skill/je soběstačná složka a instaluje se stejně jako všechno, co nástroj vyrobí — jako plugin do Claude Code, nebo symlinkem do složky se skilly, kterou tvůj agent čte. CI na manifesty pouštíclaude plugin validate --strict.
stav a co dál
Verze 0.6.0, dva měsíce po 0.4. Verze 0.5 přidala všechno, co se poslouchá — podcasty, audio soubory, videa bez titulků — a k tomu kanály, tematické skilly, obnovu skillů, CLI balíček a galerii příkladů. Verze 0.6 přidala celé podcasty z RSS, tabulky v knihách a článcích a dokumentaci z repozitářů v pořadí, jaké zamýšleli autoři. Instalace v Claude Code jsou pořád dva řádky, /plugin marketplace add michalstrnadel/source-to-skill a /plugin install source-to-skill@source-to-skill, a stejná složka funguje i v GitHub Copilot CLI nebo v Ampu, protože Agent Skills je otevřený formát.
Co hotové není, říkám rovnou. Balíček je sestavený a release workflow připravený, ale na PyPI zatím není, takže CLI se zatím instaluje přes uvx přímo z gitu. Naskenovaná PDF bez textové vrstvy pořád potřebují nejdřív OCR a podcast s víc mluvčími nemá jejich označení. A to největší: neměřil jsem, jestli agent se skillem odpovídá líp než bez něj. Evaly jsou na roadmapě. Do té doby je důkazem galerie, kterou si můžeš přečíst celou.